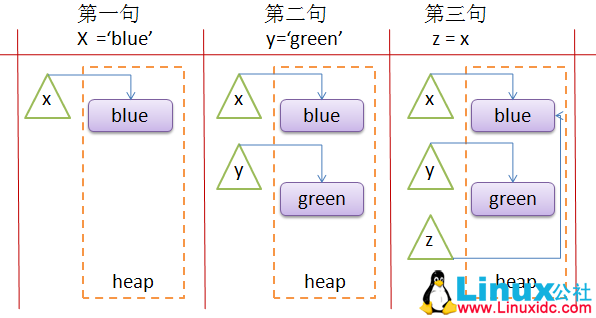
Python 中一切都是对象,变量中存放的是对象的引用。
 x = 'blue'
 y = 'green'
 z = x
当Python执行上面第一句的时候,会在heap中首先创建一个str对象,其文本内容为blue,同时还创建一个名为x的对象引用,x引用的就是这个str对象。
第二句也是类似;
第三条创建了一个名为z的新对象引用,并将其设置为对象引用x所指向的相同对象。
1、Python 中的变量不需要声明类型
2、用“=”号来给变量赋值
3、每个变量在使用前都必须赋值,变量赋值以后才会被创建。
4、Python允许同时为多个变量赋值。
a = b = c = 1
5、可以同时为多个变量赋值,用逗号分隔,逐一对应。
a, b, c = 1, 2, 3,最后a是1,b是2,c是3.
1、数字
a. int(整型)
在32位机器上,整数的位数为32位,取值范围为-231~231-1,即-2147483648~2147483647 在64位系统上,整数的位数为64位,取值范围为-263~263-1,即-9223372036854775808~9223372036854775807
b. long(长整型)
跟C语言不同,Python的长整数没有指定位宽,即:Python没有限制长整数数值的大小,但实际上由于机器内存有限,长整数数值不可能无限大。 注意,自从Python2.2起,如果整数发生溢出,Python会自动将整数数据转换为长整数,所以如今在长整数数据后面不加字母L也不会导致严重后果了。
c. float(浮点型)
浮点数用来处理实数,即带有小数的数字。类似于C语言中的double类型,占8个字节(64位),其中52位表示底,11位表示指数,剩下的一位表示符号。
d. complex(复数) 复数由实数部分和虚数部分组成,一般形式为x+yj,其中的x是复数的实数部分,y是复数的虚数部分,这里的x和y都是实数。
注:Python中存在小数字池:-5 ~ 257
2、字符串
split
>>> a  = 'hello world'
>>> b = a.split('l')
>>> b
['he', '', 'o wor', 'd']
>>>
len 字符串长度获取
>>> a  = 'hello world'
>>> b = len(a)
>>> b
11
>>>
replace
>>> a  = 'hello world'
>>> b = a.replace('l','t')
>>> b
'hetto wortd'
>>>
[] 截取字符串
注意:一定要搞清楚下标是从0开始的,列表右边的元素是不被包含的
>>>a = '0123456789'
>>>b = a[0:3] # 截取第一位到第三位的字符
>>>b
'012'

>>>b = a[:] # 截取字符串的全部字符
>>>b
'0123456789'

>>>b = a[6:] # 截取第七个字符到结尾
>>>b
'6789'

>>>b = a[:-3] # 截取从头开始到倒数第三个字符之前
>>>b
'0123456'

>>>b = a[2] # 截取第三个字符
>>>b
'2'

>>>b = a[-1] # 截取倒数第一个字符
>>>b
'9'

>>>b = a[::-1] # 创造一个与原字符串顺序相反的字符串
>>>b
'9876543210'

>>>b = a[-3:-1] # 截取倒数第三位与倒数第一位之前的字符
>>>b
'78'

>>>b = a[-3:] # 截取倒数第三位到结尾
>>>b
'789'
3、list
实质是长度可变的动态数组,并不是链表
len() 方法返回对象(字符、列表、元组等)长度或项目个数。
4、元组
元组其实也称为只读列表,列表支持的函数元组同样也支持,唯一区别是元组tuple中的数据不能被修改,这就意味着不能删除元组tuple中的数据,也不能直接给元组tuple中的数据赋值。
5、字典
字典是通过散列表或说哈希表实现的
>>> d = {'Michael': 95, 'Bob': 75, 'Tracy': 85}
>>> d['Michael']
95
6、集合
要创建一个set,需要提供一个list作为输入集合
>>> s = set([1, 1, 2, 2, 3, 3])
>>> s
{1, 2, 3}
for 变量 in 可迭代对象(序列):
    循环语句块
range()函数介绍
Python中range()函数返回的是一个整数序列的对象,一般用在 for 循环中。
函数语法 range(start, stop,[step]) 参数说明:start: 计数从start开始。默认是从 0 开始。end: 计数到end结束,但不包括 end。step:步长,默认为1。
range(10)  # 从 0 开始到 0, 1, 2, 3, 4, 5, 6, 7, 8, 9
range(1, 11) # 从 1 开始到 11 [1, 2, 3, 4, 5, 6, 7, 8, 9, 10]
range(0, 30, 5)  # 步长为 5 [0, 5, 10, 15, 20, 25]
range(-10, 0, 2)  # 负数 [-10, -8, -6, -4, -2]
while 条件表达式 :
    代码块
else :
    代码块
def 函数名(参数1,参数2....参数n):
    函数体
    return 语句
- 函数代码块以 def 关键词开头,后接函数标识符名称和圆括号()
- 任何传入参数和自变量必须放在圆括号中间。圆括号之间可以用于定义参数
- 函数的第一行语句可以选择性地使用文档字符串(用于存放函数说明)
- 函数内容以冒号起始,并且缩进
- return [表达式] 结束函数,选择性地返回一个值给调用方。不带表达式的 return 相当于返回 Non
class MyClass(object):
    def __init__(self):
        print("MyClass类的构造方法被调用!")

class1=MyClass()
class MyClass(object):
    def __init__(self,data1,data2):
        self.__data1=data1
        self.data2=data2

class1=MyClass('first_data','sencond_data')
print(class1.data2)
self代表当前类的实例
类的封装有两层含义,一个是对数据的封装,一个是对实现逻辑即方法的封装。
- Python中以双下划线开头的字段访问级别是private;
- Python中以下划线开头的字段访问级别是protected;
- Python中未以下划线开头的字段的访问级别是public;
class 类名([父类名[,父类名[,...]]]):
    pass
Python类中没有方法的重载,对于具有相同名称的方法,后面的定义会覆盖掉前面的定义;子类会覆盖父类中同名的方法。
如果你想强制调用父类的成员可以使用super()函数。
语法:super(子类名, self).方法名(),需要传入的是子类名和self,调用的是父类里的方法,按父类的方法需要传入参数。
class A:
    def __init__(self, name):
        self.name = name
        print("父类的__init__方法被执行了!")
    def show(self):
        print("父类的show方法被执行了!")

class B(A):
    def __init__(self, name, age):
        super(B, self).__init__(name=name)
        self.age = age

    def show(self):
        super(B, self).show()

obj = B("jack", 18)
obj.show()
1、__init__方法是面向对象编程中,给未来创建的对象所定义的初始化属性。当对象一旦被创建,Python将会自动调用__init__方法,里面的属性将会赋予这个对象
class Teacher(object):
    def __init__(self,name,age):
        self.name = name
        self.age = age


t1 = Teacher('zs',30)
2、__init__是属于Python中的魔法方法。所谓魔法方法,即是Python中内置的、当进行特定操作时,会自动调用的方法,表现为方法名前后有两个下划线
3、__new__方法是将对象创建出来的方法。在实际运行中,先走__new__方法,生成对象并返回,后调用__init__方法,将对象的引用传给__init__方法中的self
lass Teacher(object):
    def __init__(self):
        print('__init__')

    def __new__(cls,*args,**kwargs):
        print('__new__')
        return object.__new__(cls)

t1 = Teacher()
和java的tostring一样
    def __str__(self):
        """返回一个对象的描述信息"""
        # print(num)
        return "名字是:%s , 年龄是:%d" % (self.name, self.age)
python语言中,可以在函数定义中使用*args和kwargs传递可变长参数。其中,*args用作传递非命名键值可变长参数列表(位置参数);kwargs用作传递键值可变长参数列表。
1、*args的使用方法
*args 用来将参数打包成tuple(元组)给函数体调用
def function(x, y, *args):
    print(x, y, args)

function(1, 2, 3, 4, 5)
2、**kwargs的使用方法
**kwargs 用来将参数打包成dict(字典)t给函数体调用
def function(**kwargs):
    print(kwargs)

function(a=1, b=2, c=3)
3、 arg,*args和**kwargs的使用方法
参数arg、*args、**kwargs三个参数的位置必须是一定的。必须是(arg,*args,**kwargs)这个顺序,否则程序会报错。
 def function(arg,*args,**kwargs):
    print(arg,args,kwargs)

function(6,7,8,9,a=1, b=2, c=3)
1、读文件
with open('/path/to/file', 'r') as f:
    print(f.read())
二进制文件
前面讲的默认都是读取文本文件,并且是UTF-8编码的文本文件。要读取二进制文件,比如图片、视频等等,用'rb'模式打开文件即可:
>>> f = open('/Users/michael/test.jpg', 'rb')
>>> f.read()
b'\xff\xd8\xff\xe1\x00\x18Exif\x00\x00...' # 十六进制表示的字节
字符编码
要读取非UTF-8编码的文本文件,需要给open()函数传入encoding参数,例如,读取GBK编码的文件:
>>> f = open('/Users/michael/gbk.txt', 'r', encoding='gbk')
>>> f.read()
'测试'
2、写文件
with open('/Users/michael/test.txt', 'w') as f:
    f.write('Hello, world!')
在python中读写操作资源,最后需要释放资源。可以使用try…finally结构实现资源的正确释放,python提供了一个with语句能更简便的实现释放资源。
with open('data', 'r', encoding='utf-8') as f:
    data = f.readlines()
上面的写法,与下面的写法在最终效果上是一致的
f = open('data', 'r', encoding='utf-8')
try:
    data = f.readlines()
except:
    pass
finally:
    f.close()
对比两段代码不难发现,使用with语句时,代码更加简洁,而且不用主动关闭文件,在with语句体退出时,会自动关闭文件,即便with语句体中发生了异常。
import copy
a = [1,2,3,4,5]
b = a   #浅拷贝,a,b同时指向一个id,当其中一个修改时,另外一个也会被修改。
c = copy.deepcopy(a) #深拷贝,c单独开辟一个id,用来存储和a一样的内容。
d =a[:] #这样也是深拷贝。
e = copy.copy(a) #当拷贝内容是可变类型时,那么就会进行深拷贝,如果是不可变类型时,那么就会进行浅拷贝。
Python GC主要使用引用计数(reference counting)来跟踪和回收垃圾。在引用计数的基础上,通过“标记-清除”(mark and sweep)解决容器对象可能产生的循环引用问题,通过“分代回收”(generation collection)以空间换时间的方法提高垃圾回收效率。
PyObject是每个对象必有的内容,其中ob_refcnt就是做为引用计数。当一个对象有新的引用时,它的ob_refcnt就会增加,当引用它的对象被删除,它的ob_refcnt就会减少.引用计数为0时,该对象生命就结束了。
优点:
- 简单
- 实时性
缺点:
- 维护引用计数消耗资源
- 循环引用
基本思路是先按需分配,等到没有空闲内存的时候从寄存器和程序栈上的引用出发,遍历以对象为节点、以引用为边构成的图,把所有可以访问到的对象打上标记,然后清扫一遍内存空间,把所有没标记的对象释放。
分代回收的整体思想是:将系统中的所有内存块根据其存活时间划分为不同的集合,每个集合就成为一个“代”,垃圾收集频率随着“代”的存活时间的增大而减小,存活时间通常利用经过几次垃圾回收来度量。
Python默认定义了三代对象集合,索引数越大,对象存活时间越长。
1、set()
当需要对一个列表进行去重操作的时候,set()函数就派上用场了。
obj = ['a','b','c','b','a']
print(set(obj))
# 输出:{'b', 'c', 'a'}
集合对象创建后,还能使用并集、交集、差集功能。
A = set('hello')
B = set('world')

A.union(B) # 并集,输出:{'d', 'e', 'h', 'l', 'o', 'r', 'w'}
A.intersection(B) # 交集,输出:{'l', 'o'}
A.difference(B) # 差集,输出:{'d', 'r', 'w'}
2、sorted()
在处理数据过程中,我们经常会用到排序操作,比如将列表、字典、元组里面的元素正/倒排序。
这时候就需要用到sorted() ,它可以对任何可迭代对象进行排序,并返回列表。
对列表升序操作:
a = sorted([2,4,3,7,1,9])
print(a)
# 输出:[1, 2, 3, 4, 7, 9]
对元组倒序操作:
sorted((4,1,9,6),reverse=True)
print(a)
# 输出:[9, 6, 4, 1]
3、reversed()
如果需要对序列的元素进行反转操作,reversed()函数能帮到你。
reversed()接受一个序列,将序列里的元素反转,并最终返回迭代器。
a = reversed('abcde')
print(list(a))
# 输出:['e', 'd', 'c', 'b', 'a']

b = reversed([2,3,4,5])
print(list(b))
# 输出:[5, 4, 3, 2]
4、len
str = "runoob"
print( len(str) )          # 字符串长度

l = [1,2,3,4,5]
print( len(l) )            # 列表元素个数
装饰器本质上是一个 Python 函数或类,它可以让其他函数或类在不需要做任何代码修改的前提下增加额外功能,装饰器的返回值也是一个函数/类对象。它经常用于有切面需求的场景,比如:插入日志、性能测试、事务处理、缓存、权限校验等场景,装饰器是解决这类问题的绝佳设计。有了装饰器,我们就可以抽离出大量与函数功能本身无关的雷同代码到装饰器中并继续重用。概括的讲,装饰器的作用就是为已经存在的对象添加额外的功能。
简单装饰器:
def use_logging(func):

    def wrapper():
        logging.warn("%s is running" % func.__name__)
        return func()   # 把 foo 当做参数传递进来时,执行func()就相当于执行foo()
    return wrapper

def foo():
    print('i am foo')

foo = use_logging(foo)  # 因为装饰器 use_logging(foo) 返回的时函数对象 wrapper,这条语句相当于  foo = wrapper
foo()
语法糖:
def use_logging(func):

    def wrapper():
        logging.warn("%s is running" % func.__name__)
        return func()
    return wrapper

@use_logging
def foo():
    print("i am foo")

foo()如果要自定义实现一个迭代器,则类中必须实现如下 2 个方法:
- next(self):返回容器的下一个元素。
- iter(self):该方法返回一个迭代器(iterator)。
class PowTwo:
    """Class to implement an iterator
    of powers of two"""

    def __init__(self, max = 0):
        self.max = max

    def __iter__(self):
        self.n = 0
        return self

    def __next__(self):
        if self.n <= self.max:
            result = 2 ** self.n
            self.n += 1
            return result
        else:
            raise StopIteration
>>> a = PowTwo(4)
>>> i = iter(a)
>>> next(i)
1
>>> next(i)
2
>>> next(i)
4
>>> next(i)
8
>>> next(i)
16
>>> next(i)
Traceback (most recent call last):
...
StopIteration
我们也可以用for循环来迭代它:
>>> for i in PowTwo(5):
...     print(i)
...
1
2
4
8
16
32
生成器是一个特殊的程序,可以被用作控制循环的迭代行为,python中生成器是迭代器的一种,使用yield返回值函数,每次调用yield会暂停,而可以使用next()函数和send()函数恢复生成器。
(1)括号创建法
在Python当中,我们经常这样初始化一个数组:
arr = [i * 3 for i in range(10)]我们稍微变形一下,就得到了一个最简单的生成器
g = (i * 3 for i in range(10))

print(next(g))
看清楚了吗,其实和list没什么差别,只是我们将最外层的括号从[]换成了()。
这样和上面用[]定义有什么区别呢?
其实是有区别的,如果没有区别,那么我们用生成器也就没有意义了。它的区别也就是生成器的意义,简单来说,我们前文中已经说过了当定义一个list的时候,Python会自动将for循环执行一遍,然后将结果写入进list当中。但是生成器不会,虽然我们也用到了for循环,但是它只是起到了限制个数的作用,在执行完这一步之后,Python并不会将for循环执行结束。只有我们每次调用next,才会触发它进行一次循环。
(2)函数创建法
def gtr(n):
    for i in range(n):
        yield i
def test():
n = 0
while True:
if n < 3:
yield n
n += 1
else:
yield 10
if __name__ == '__main__':
t = test()
for i in range(10):
print(next(t))我们如果执行上面这段代码,前三个数是0,1和2,从第四个数开始一直是10。
import threading
from threading import Lock,Thread
1、普通创建方式
def run(n):
    print('task',n)
    time.sleep(1)
    print('2s')
    time.sleep(1)
    print('1s')
    time.sleep(1)
    print('0s')
    time.sleep(1)

if __name__ == '__main__':
    t1 = threading.Thread(target=run,args=('t1',))     # target是要执行的函数名(不是函数),args是函数对应的参数,以元组的形式存在
    t2 = threading.Thread(target=run,args=('t2',))
    t1.start()
    t2.start()
2、自定义线程
class MyThread(threading.Thread):
    def __init__(self,n):
        super(MyThread,self).__init__()   #重构run函数必须写
        self.n = n

    def run(self):
        print('task',self.n)
        time.sleep(1)
        print('2s')
        time.sleep(1)
        print('1s')
        time.sleep(1)
        print('0s')
        time.sleep(1)

if __name__ == '__main__':
    t1 = MyThread('t1')
    t2 = MyThread('t2')
    t1.start()
t2.start()from multiprocessing import Process
1、普通创建方式
from multiprocessing import  Process
def fun1(name):
    print('测试%s多进程' %name)

if __name__ == '__main__':
    process_list = []
    for i in range(5):  #开启5个子进程执行fun1函数
        p = Process(target=fun1,args=('Python',)) #实例化进程对象
        p.start()
        process_list.append(p)

    for i in process_list:
        p.join()

    print('结束测试')
2、自定义进程
from multiprocessing import  Process

class MyProcess(Process): #继承Process类
    def __init__(self,name):
        super(MyProcess,self).__init__()
        self.name = name

    def run(self):
        print('测试%s多进程' % self.name)


if __name__ == '__main__':
    process_list = []
    for i in range(5):  #开启5个子进程执行fun1函数
        p = MyProcess('Python') #实例化进程对象
        p.start()
        process_list.append(p)

    for i in process_list:
        p.join()

print('结束测试')1、尽量用 enumerate 取代 range
for i, flavor in enumerate(flavor_list):
    print(f'{i + 1}: {flavor}')
- enumerate 函数可以用简洁的代码迭代 iterator,而且可以指出当前这轮循环的序号。
- 不要先通过 range 指定下标的取值范围,然后用下标去访问序列,而是应该直接用 enumerate 函数迭代。
- 可以通过 enumerate 的第二个参数指定起始序号(默认为 0)。
2、不要在 for 与 while 循环后写 else
Python 有种特殊的语法,可以把 else 块紧跟在整个 for 循环或 while 循环的后面。 只有在整个循环没有因为 break 提前跳出的情况下,else 块才会执行。 把 else 块紧跟在整个循环后面,会让人不太容易看出这段代码的意思,所以要避免这样写。
3、学会对序列做切片
- 切片要尽可能写得简单一些:如果从头开始选取,就省略起始下标 0 ;如果选到序列末尾,就省略终止下标。
- 切片允许起始下标或终止下标越界,所以很容易就能表达“取开头多少个元素”(例如 a[:20])或“取末尾多少个元素”(例如 a[-20:0])等含义,而不用担心切片是否真有这么多元素。
- 把切片放在赋值符号的左侧可以将原列表中这段范围内的元素用赋值符号右侧的元素替换掉,但可能会改变原列表的长度。
pip install PyQt5-tools
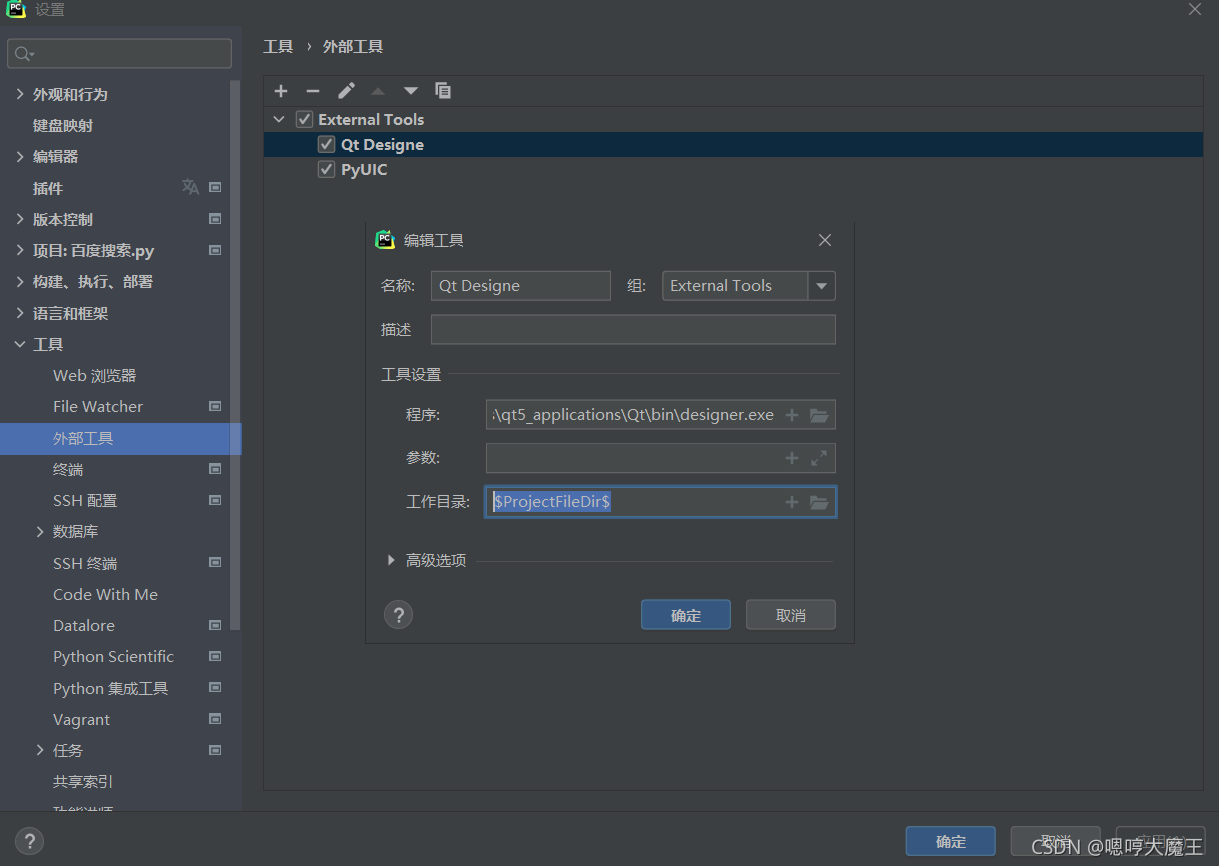
名称:Qt Designe

程序:C:\Users\a1254\Desktop\python\pyqt\venv\Lib\site-packages\qt5_applications\Qt\bin\designer.exe

工作目录:$ProjectFileDir$
添加:PyUIC(点击加号)按照下方的规则填写,如图所示:
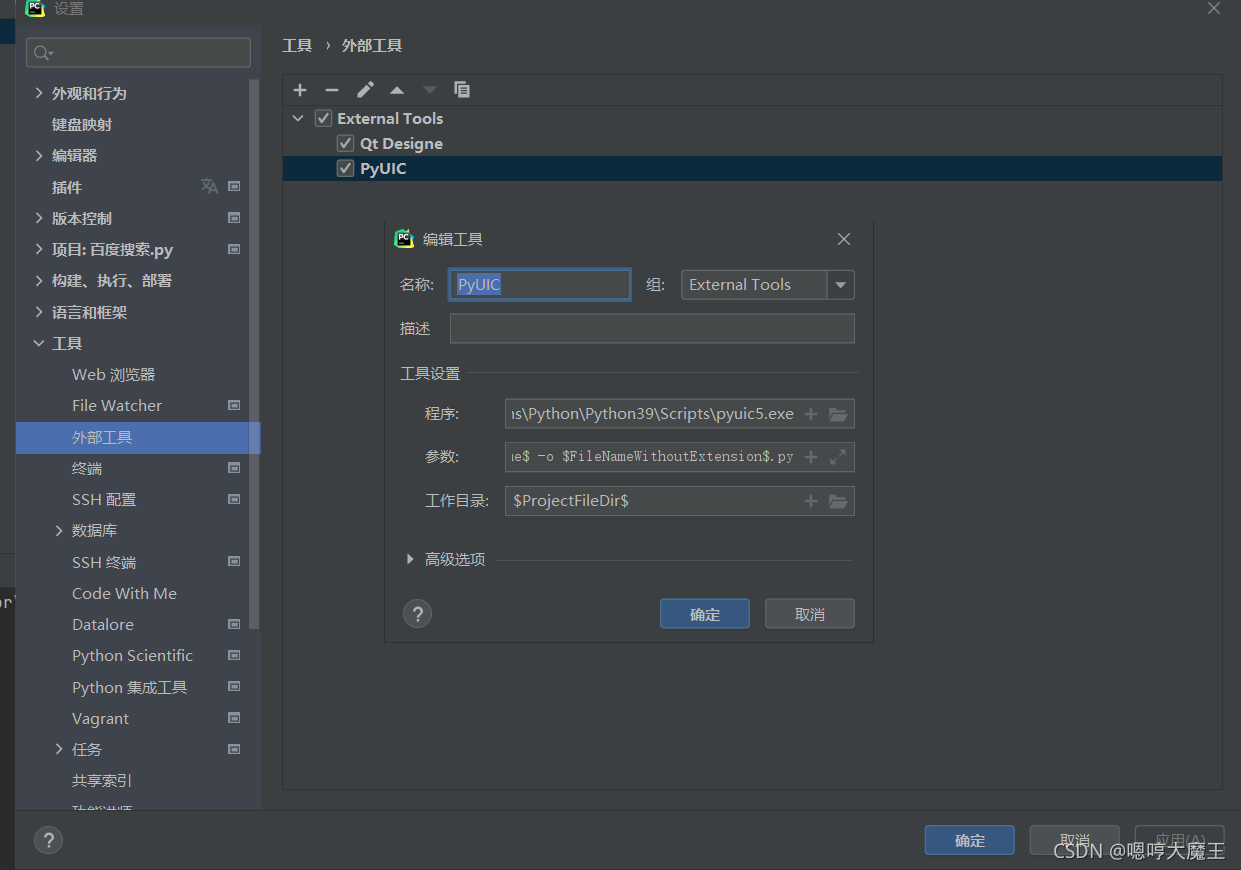
名称:PyUIC

程序:C:\Users\Administrator\AppData\Local\Programs\Python\Python39\Scripts\pyuic5.exe

参数:$FileName$ -o $FileNameWithoutExtension$.py

工作目录:$ProjectFileDir$
可以将ui文件转换为py文件
pyuic5 -o main.py proxy.ui
当pyuic5将ui文件转换成py文件的时候,此时会自动生成一个只包含Ui_MainWindow的类,类之外没有可以执行的代码,当你执行这个代码的时候,不会报错,但是什么也不会发生。如果要显示UI界面的话,可以在生成的py代码中添加几行代码就可以啦
生成的.py文件自动引入了PyQt5库中的几个大类:QtCore, QtGui, QtWidgets等;(你用到什么类,他就自动生成什么类)也可以输入from PyQt5.QtWidgets import *,这样就会把所有的类都导入啦
#from PyQt5 import QtCore, QtGui, QtWidgets
import sys
if __name__ == "__main__":
app = QtWidgets.QApplication(sys.argv) # 创建一个QApplication,也就是你要开发的软件app
MainWindow = QtWidgets.QMainWindow() # 创建一个QMainWindow,用来装载你需要的各种组件、控件
ui = Ui_MainWindow() # ui是Ui_MainWindow()类的实例化对象
ui.setupUi(MainWindow) # 执行类中的setupUi方法,方法的参数是第二步中创建的QMainWindow
MainWindow.show() # 执行QMainWindow的show()方法,显示这个QMainWindow
sys.exit(app.exec_()) # 使用exit()或者点击关闭按钮退出QApplicat信号:被点击
当按钮被点击就会发出 clicked 信号,可以这样指定处理该信号的函数
button.clicked.connect(handleCalc)改变文本
代码中可以使用 setText 方法来改变按钮文本,比如
button.setText(text)禁用、启用
所有控件(继承自QWidget类)都支持 禁用和启用方法。
禁用后,该控件不再处理用户操作
- 禁用
button.setEnabled(False)- 启用
button.setEnabled(True)信号:文本被修改
当文本框中的内容被键盘编辑,被点击就会发出 textChanged 信号,可以这样指定处理该信号的函数
edit.textChanged.connect(handleTextChange)Qt在调用这个信号处理函数时,传入的参数就是 文本框目前的内容字符串。
信号:按下回车键
当用户在文本框中任何时候按下回车键,就会发出 returnPressed 信号。
有时我们需要处理这种情况,比如登录界面,用户输完密码直接按回车键就进行登录处理,比再用鼠标点击登录按钮快捷的多。
可以指定处理 returnPressed 信号,如下所示
passwordEdit.returnPressed.connect(onLogin)获取文本
通过 toPlainText() 方法获取编辑框内的文本内容,比如
text = edit.toPlainText()设置文本
通过 setText 方法设置编辑框内的文本内容为参数里面的文本字符串,比如
edit.setText('你好,白月黑羽')原来的所有内容会被清除
改变文本
代码中可以使用 setText 方法来改变标签文本内容,比如
button.setText(text)信号:选项改变
如果用户操作修改了QComboBox中的选项就会发出 currentIndexChanged 信号,可以这样指定处理该信号的函数
cbox.currentIndexChanged.connect(handleSelectionChange)获取当前选项文本
代码中可以使用 currentText 方法来获取当前 选中的选项 的文本,比如
method = cbox.currentText()添加一个选项
代码中可以使用 addItem 方法来添加一个选项到 末尾 ,参数就是选项文本
listWidget.addItem('byhy')删除一个选项
代码中可以使用 takeItem 方法来删除1个选项,参数是该选项所在行
listWidget.takeItem(1)就会删除第二行选项
清空选项
代码中可以使用 clear 方法来清空选项,也就是删除选择框内所有的选项
listWidget.clear()获取当前选项文本
currentItem 方法可以得到列表当前选中项对象(QListWidgetItem) ,再调用这个对象的 text 方法,就可以获取文本内容,比如
listWidget.currentItem().text()可以使用 item 方法获取指定某行的 QListWidgetItem,
比如,
listWidget.item(0).text()就获取了 第1行 的列表项的文本。
插入一行、删除一行
insertRow 方法可以在指定位置插入一行,比如
table.insertRow(0)就插入一行到第 1 行这个位置, 表格原来第1行(包括原来的第1行)以后的内容,全部往下移动一行。
table.insertRow(2)就插入一行到第 3 行这个位置, 表格原来第3行(包括原来的第3行)以后的内容,全部往下移动一行。
removeRow 方法可以删除指定位置的一行,比如
table.removeRow(0)就删除第 1 行, 表格原来第1行以后的内容,全部往上移动一行。
table.removeRow(2)就删除第 3 行, 表格原来第3行以后的内容,全部往上移动一行。
设置单元格内容、对齐、属性
qt表格的单元格内的内容对象 是一个 单元格对象 QTableWidgetItem 实例
如果单元格 没有被设置过 内容,可以这样
from PySide2.QtWidgets import QTableWidgetItem

item = QTableWidgetItem()
item.setText('白月黑羽')
table.setItem(row, 0, item)
也可以简写为
from PySide2.QtWidgets import QTableWidgetItem

table.setItem(row, 0, QTableWidgetItem('白月黑羽'))
如果单元格 已经被设置过 文本内容,
item 方法可以获取指定位置的 QTableWidgetItem ,再调用这个对象的 setText 方法,就可以设置单元格文本内容,比如
table.item(0,0).setText('白月黑羽-江老师')就设置了 第1行,第1列 的单元格里面的文本。
table.item(2,4).setText('白月黑羽-江老师')就设置了 第3行,第5列 的单元格里面的文本。
获取单元格文本的内容
item 方法可以指定位置的单元格对象(QTableWidgetItem) ,再调用这个对象的 text 方法,就可以获取文本内容,比如
table.item(0,0).text()就获取了 第1行,第1列 的单元格里面的文本。
table.item(2,4).text()就获取了 第3行,第5列 的单元格里面的文本。
获取所有行数、列数
代码中可以使用 rowCount 方法来获取表格所有的 行数 ,比如
rowcount = table.rowCount()可以使用 columnCount 方法来获取表格所有的 列数 ,比如
rowcount = table.columnCount()获取当前选中是第几行
代码中可以使用 currentRow 方法来获取当前选中是第几行,比如
currentrow = table.currentRow()注意:行数是从0开始的, 第一行的行数是 0
选择目录
通过 getExistingDirectory 静态方法 选择目录。
该方法,第一个参数是父窗口对象,第二个参数是选择框显示的标题。
比如
from PySide2.QtWidgets import QFileDialog

filePath = QFileDialog.getExistingDirectory(self.ui, "选择存储路径")
返回值即为选择的路径字符串。
如果用户点击了 选择框的 取消选择按钮,返回 空字符串。
选择单个文件
如果你想弹出文件选择框,选择一个 已经存在 的文件,可以使用 QFileDialog 静态方法 getOpenFileName ,比如
from PySide2.QtWidgets import QFileDialog

filePath, _  = QFileDialog.getOpenFileName(
            self.ui,             # 父窗口对象
            "选择你要上传的图片", # 标题
            r"d:\\data",        # 起始目录
            "图片类型 (*.png *.jpg *.bmp)" # 选择类型过滤项,过滤内容在括号中
        )
该方法返回值 是一个元组,第一个元素是选择的文件路径,第二个元素是文件类型,如果你只想获取文件路径即可,可以采用上面的代码写法。
如果用户点击了 选择框的 取消选择按钮,返回 空字符串。
如果你想弹出文件选择框,选择路径和文件名,来 保存一个文件 ,可以使用 QFileDialog 静态方法 getSaveFileName ,比如
from PySide2.QtWidgets import QFileDialog

filePath, _  = QFileDialog.getSaveFileName(
            self.ui,             # 父窗口对象
            "保存文件", # 标题
            r"d:\\data",        # 起始目录
            "json类型 (*.json)" # 选择类型过滤项,过滤内容在括号中
)错误:
QMessageBox.critical(
    self.ui,
    '错误',
    '请选择爬取数据存储路径!')
警告
QMessageBox.warning(
    self.ui,
    '阅读太快',
    '阅读客户协议必须超过1分钟')
提示
QMessageBox.information(
    self.ui,
    '操作成功',
'请继续下一步操作')from PySide2.QtWidgets import QInputDialog,QLineEdit
# 返回值分别是输入数据 和 是否点击了 OK 按钮(True/False)
title, okPressed = QInputDialog.getText(
self,
"输入目录名称",
"名称:",
QLineEdit.Normal,
"")
if not okPressed:
print('你取消了输入')
import requests, json

# 带参数表单类型post请求
data={'custname': 'woodman','custtel':'13012345678','custemail':'woodman@11.com',
     'size':'small'}
r = requests.post('http://httpbin.org/post', data=data)
print('响应数据:', r.text)# json数据请求
url = 'https://api.github.com/some/endpoint'
payload = {'some': 'data'}
# 可以使用json.dumps(dict) 对编码进行编译
r = requests.post(url, data=json.dumps(payload))
print('响应数据:', r.text)
# 可以直接使用json参数传递json数据
r = requests.post(url, json=payload)
print('响应数据:', r.text)# 上传单个文件
url = 'http://httpbin.org/post'
# 注意文件打开的模式,使用二进制模式不容易发生错误
files = {'file': open('report.txt', 'rb')}
# 也可以显式地设置文件名,文件类型和请求头
# files = {'file': ('report.xls', open('report.xls', 'rb'), 'application/vnd.ms-excel', {'Expires': '0'})}
r = requests.post(url, files=files)
r.encoding = 'utf-8'
print(r.text)# 直接以字典型时传递cookie
url = 'http://httpbin.org/cookies'
cookies = {"cookies_are":'working'}
r = requests.get(url, cookies=cookies)
# 获取响应的cookie信息,返回结果是RequestsCookieJar对象
print(r.cookies)
print(r.text)
import requests.cookies
# 我们也可以使用 RequestsCookieJar 对象提交cookies信息
jar = requests.cookies.RequestsCookieJar()
jar.set('tasty_cookie', 'yum', domain='httpbin.org', path='/cookies')
jar.set('gross_cookie', 'blech', domain='httpbin.org', path='/elsewhere')
url = 'http://httpbin.org/cookies'
r = requests.get(url, cookies=jar)
print(r.text)通过向规则参数添加变量部分,可以动态构建URL。
此变量部分标记为 。
它作为关键字参数传递给与规则相关联的函数。
from flask import Flask
app = Flask(__name__)

@app.route('/hello/<name>')
def hello_name(name):
   return 'Hello %s!' % name

if __name__ == '__main__':
   app.run(debug = True)
from flask import Flask
app = Flask(__name__)
@app.route('/blog/<int:postID>')
def show_blog(postID):
return 'Blog Number %d' % postID
@app.route('/rev/<float:revNo>')
def revision(revNo):
return 'Revision Number %f' % revNo
if __name__ == '__main__':
app.run()from flask import Flask, redirect, url_for, request
app = Flask(__name__)
@app.route('/success/<name>')
def success(name):
return 'welcome %s' % name
@app.route('/login',methods = ['POST', 'GET'])
def login():
if request.method == 'POST':
user = request.form['nm']
return redirect(url_for('success',name = user))
else:
user = request.args.get('nm')
return redirect(url_for('success',name = user))
if __name__ == '__main__':
app.run(debug = True)@app.errorhandler(404)
def not_found(e):
return '没找到', 404{% ... %}包含的代码是可以被执行的语句,比如循环语句,继承语法;{{ ... }}包含的是 Python 对象,用于解析出这些对象的值,经常用于打印内容;{# ... #}用于添加注释,这些注释不会被处理,但是也不会输出到 HTML 源码中;
选择:
{% if title %}
     <title> {{ title }}</title>
      {% else %}
     <title> no title </title>
 {% endif %}
循环:
<ul>
    {% for item in item_list %}
        <li>{{ item }}</li>
    {% endfor %}
</ul>
1、创建蓝图对象
# 这里的两个参数为必选,至于为什么,稍后解释
admin = Blueprint('admin',__name__)
2、使用蓝图对象注册路由
@admin.route('/')
def admin_home():
    pass
3、将蓝图注册到app上
app.register_blueprint(admin)操作数据库需要先创建一个db对象,通常写在exts.py文件里。
from flask_sqlalchemy import SQLAlchemy

db = SQLAlchemy()
flask项目一般将数据库配置写入configs.py文件里面,配置在创建引擎前需写好,不要在程序运行时修改配置,如下。
HOST = '127.0.0.1'
PORT = '3306'
DATABASE = 'flask1'
USERNAME = 'root'
PASSWORD = '123456'

DB_URI = "mysql+pymysql://{username}:{password}@{host}:{port}/{db}?charset=utf8".format(username=USERNAME,password=PASSWORD, host=HOST,port=PORT, db=DATABASE)

SQLALCHEMY_DATABASE_URI = DB_URI
SQLALCHEMY_TRACK_MODIFICATIONS = False
SQLALCHEMY_ECHO = True
写完数据库配置后需要和app绑定,app.py文件里写flask应用的创建和蓝图的注册等等,如下:
from flask import Flask
import configs
from exts import db

app = Flask(__name__)
# 加载配置文件
app.config.from_object(configs)
# db绑定app
db.init_app(app)| 数据类型 | 说明 |
|---|---|
| Integer | 整型 |
| String | 字符串 |
| Text | 文本 |
| DateTime | 日期 |
| Float | 浮点型 |
| Boolean | 布尔值 |
| PickleType | 存储一个序列化( Pickle )后的Python对象 |
| LargeBinary | 巨长度二进制数据 |
# 建表写在models.py文件里面
from ext import db

"""
以下表关系:
一个用户对应多篇文章(一对多)
一篇文章对应多个标签,一个标签对应多个文章(多对多)
"""
"""
一对一关系中,需要设置relationship中的uselist=Flase,其他数据库操作一样。
一对多关系中,外键设置在多的一方中,关系(relationship)可设置在任意一方。
多对多关系中,需建立关系表,设置 secondary=关系表
"""

# 用户表
class User(db.Model):
    id = db.Column(db.Integer, primary_key=True, autoincrement=True)
    username = db.Column(db.String(50))
    email = db.Column(db.String(50))

# 关系表(多对多)
article_tag_table = db.Table('article_tag',
                             db.Column('article_id', db.Integer, db.ForeignKey('article.id'), primary_key=True),
                             db.Column('tag_id', db.Integer, db.ForeignKey('tag.id'), primary_key=True))

# 文章表
class Article(db.Model):
    __tablename__ = 'article'
    id = db.Column(db.Integer, primary_key=True, autoincrement=True)
    title = db.Column(db.String(100))
    content = db.Column(db.Text)
    author_id = db.Column(db.Integer, db.ForeignKey('user.id'))

    author = db.relationship("User", backref="articles")
    tags = db.relationship("Tag", secondary=article_tag_table, backref='tags')

# 标签表
class Tag(db.Model):
    __tablename__ = 'tag'
    id = db.Column(db.Integer, primary_key=True, autoincrement=True)
name = db.Column(db.String(50))常用命令: 1、初始化环境:python manager.py db init 2、自动检测模型,生成迁移脚本:python manager.py db migrate 3、将迁移脚本映射到数据库中:python manager.py db upgrade 4、查看更多命令:python manager.py db --help
创建好表后需要映射到数据库中,这里需要用到flask-migrate库。下面是启动文件manage.py。
from flask_script import Manager, Server
from app import app
from flask_migrate import Migrate, MigrateCommand
from ext import db
from first import models # 模型文件必须导入进来,否则运行报错

manager = Manager(app)
Migrate(app=app, db=db)
manager.add_command('db', MigrateCommand) # 创建数据库映射命令
manager.add_command('start', Server(port=8000, use_debugger=True)) # 创建启动命令

if __name__ == '__main__':
    manager.run()
配置好启动文件后,进入项目根目录,在命令行输入以下代码:
>python manage.py db init
>python manage.py db migrate
>python manage.py db upgrade
# 原生sql语句操作
sql = 'select * from user'
result = db.session.execute(sql)

# 查询全部
User.query.all()
# 主键查询
User.query.get(1)
# 条件查询
User.query.filter_by(User.username='name')
# 多条件查询
from sqlalchemy import and_
User.query.filter_by(and_(User.username =='name',User.password=='passwd'))
# 比较查询
User.query.filter(User.id.__lt__(5)) # 小于5
User.query.filter(User.id.__le__(5)) # 小于等于5
User.query.filter(User.id.__gt__(5)) # 大于5
User.query.filter(User.id.__ge__(5)) # 大于等于5
# in查询
User.query.filter(User.username.in_('A','B','C','D'))
# 排序
User.query.order_by('age') # 按年龄排序,默认升序,在前面加-号为降序'-age'
# 限制查询
User.query.filter(age=18).offset(2).limit(3)  # 跳过二条开始查询,限制输出3条

# 增加
use = User(id,username,password)
db.session.add(use)
db.session.commit()

# 删除
User.query.filter_by(User.username='name').delete()

# 修改
User.query.filter_by(User.username='name').update({'password':'newdata'})